Sin cambios en tu aplicación
Tus aplicaciones de IA actuales usan RelAI sin rediseñar su lógica de negocio.
RelAI · by Itify
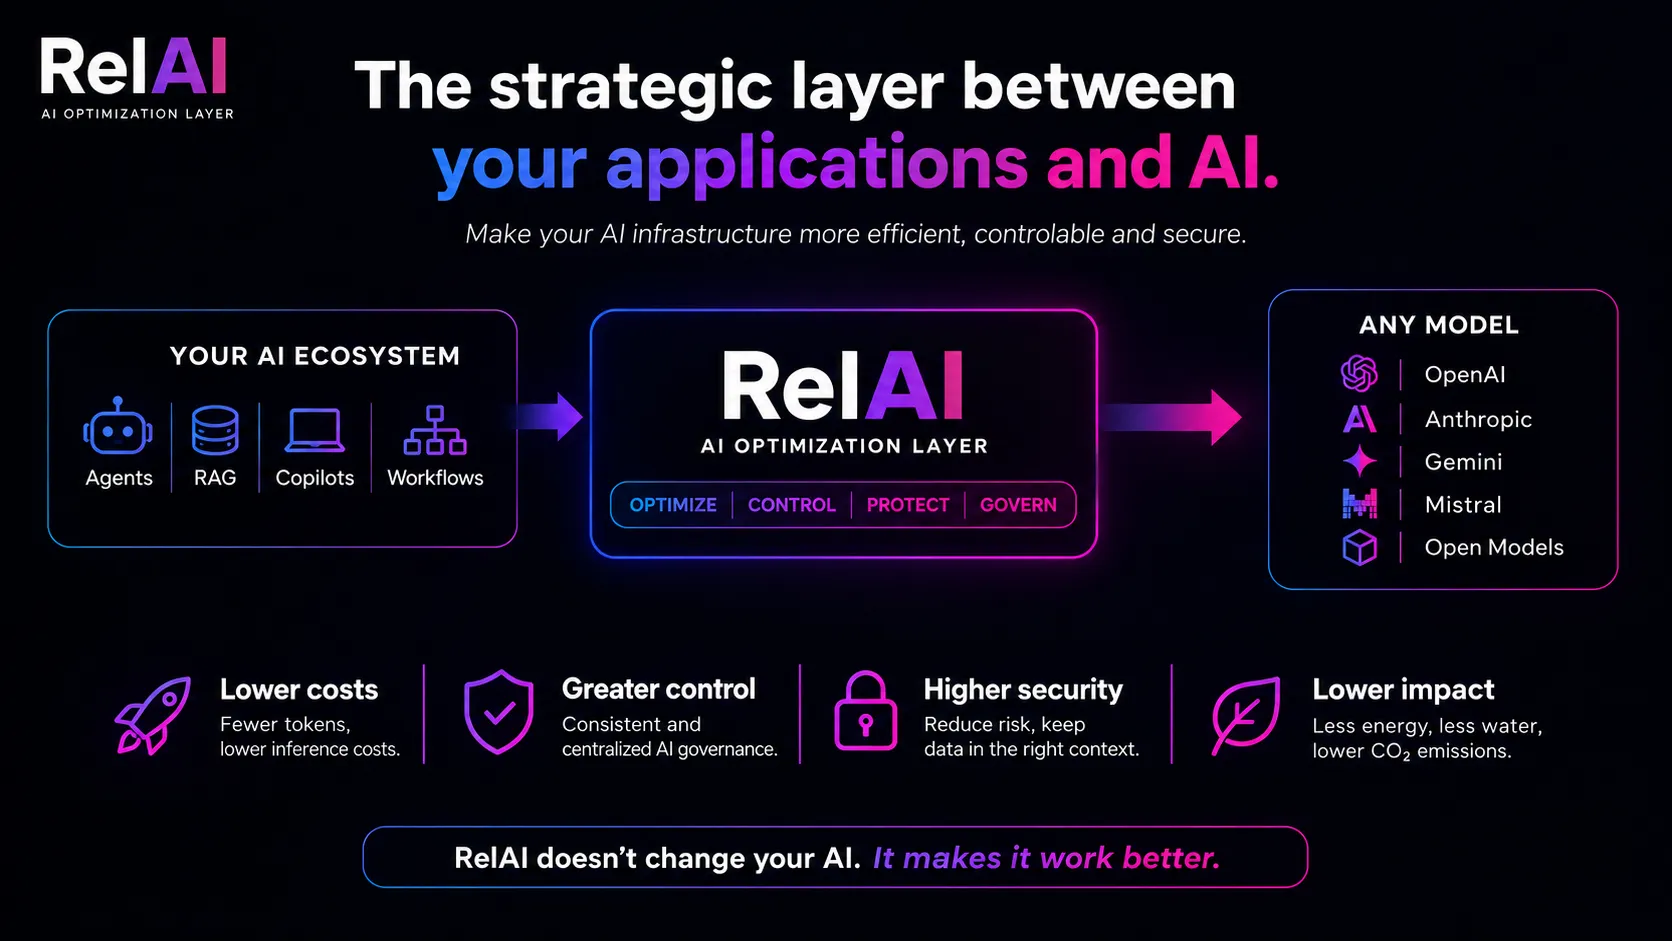
RelAI es la capa estratégica entre tus aplicaciones y la IA. Se sitúa de forma transparente entre tu software y cualquier LLM, y reduce los tokens que el modelo tiene que procesar sin degradar la calidad del resultado.
Reduce el coste. Preserva la inteligencia.
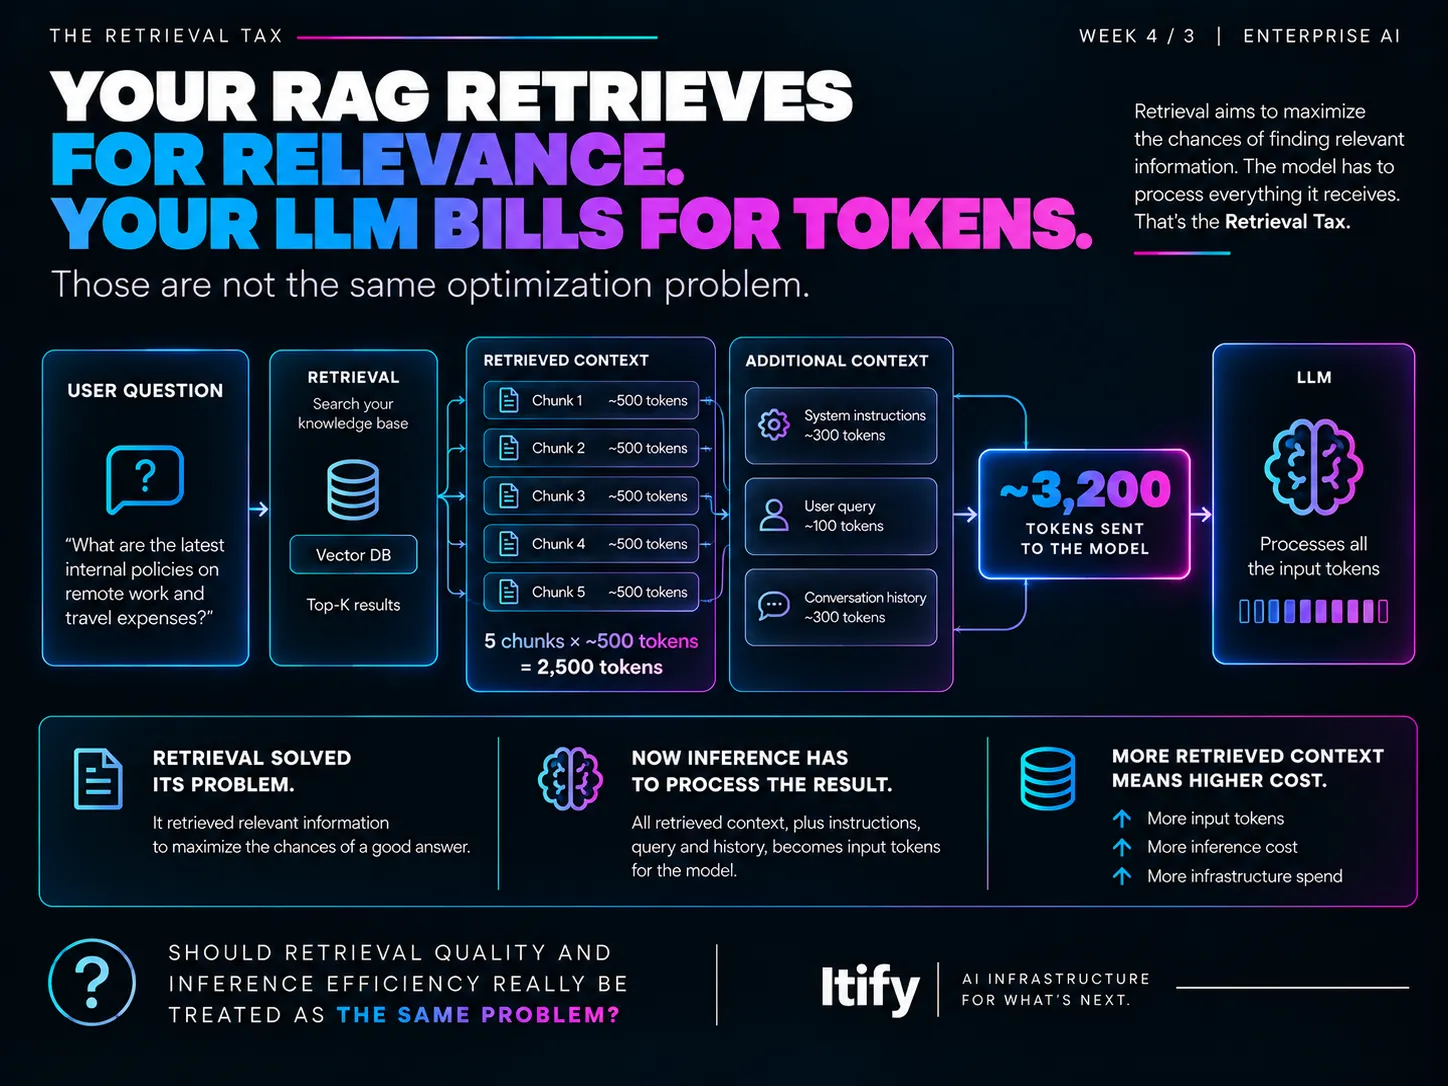
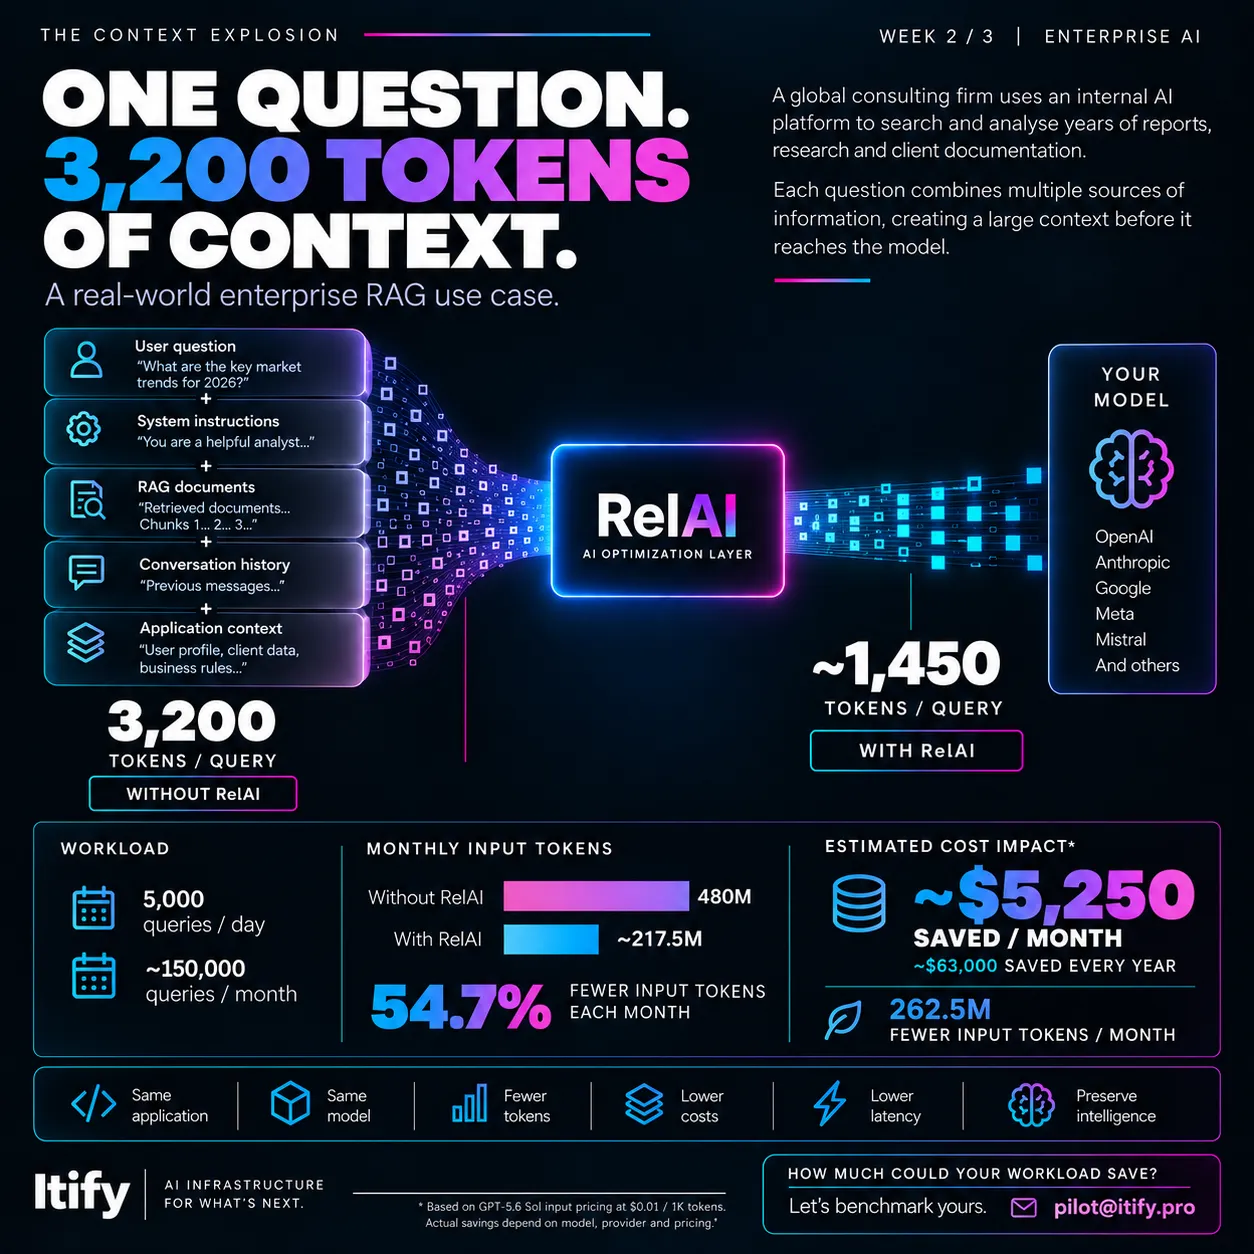
Las aplicaciones de IA están evolucionando de prompts simples a contextos largos, RAG, agentes, conversaciones y flujos complejos. Cada token adicional tiene un coste computacional y económico.
El enfoque actual es, en la práctica, «envía todo al modelo y paga por todo». RelAI cuestiona esa premisa.
RelAI analiza la información que se envía al modelo y reduce el consumo innecesario de tokens antes de la inferencia. El modelo recibe una representación más eficiente del contexto necesario. Tu aplicación sigue funcionando igual.
Tus aplicaciones de IA actuales usan RelAI sin rediseñar su lógica de negocio.
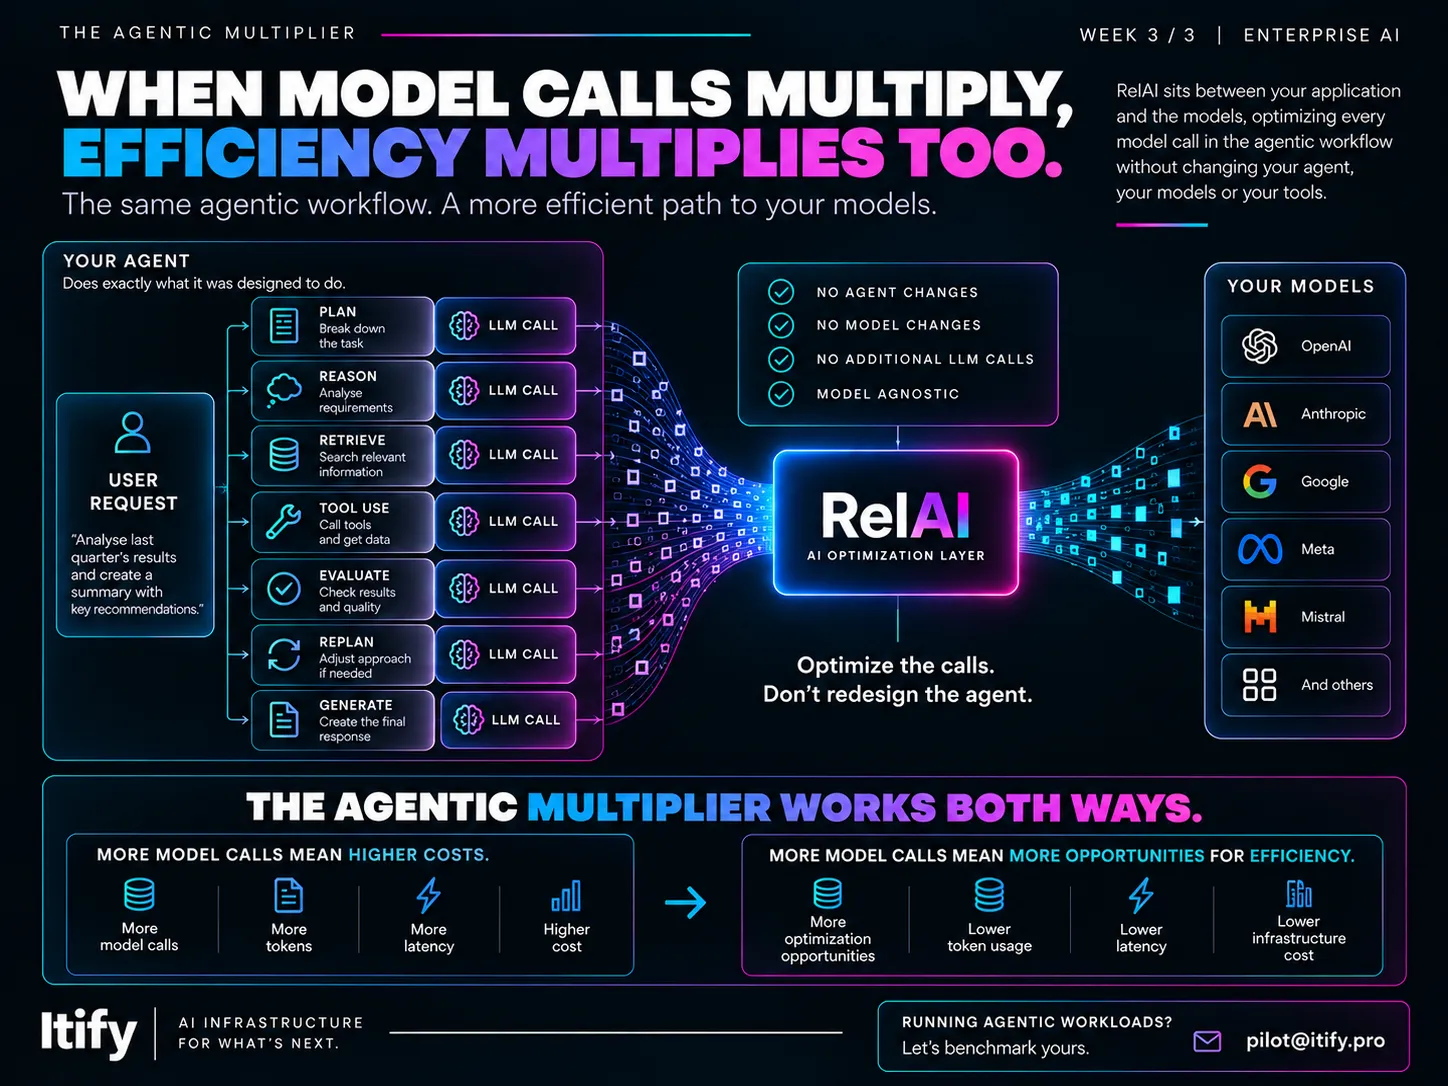
RelAI trabaja con los LLM que ya usas. No hay que reentrenar, ajustar ni sustituir modelos. Y sin llamadas adicionales al modelo.
Mantienes el control de qué modelos y proveedores usas. RelAI es una capa independiente.
RelAI no cambia tu IA. Hace que funcione mejor.
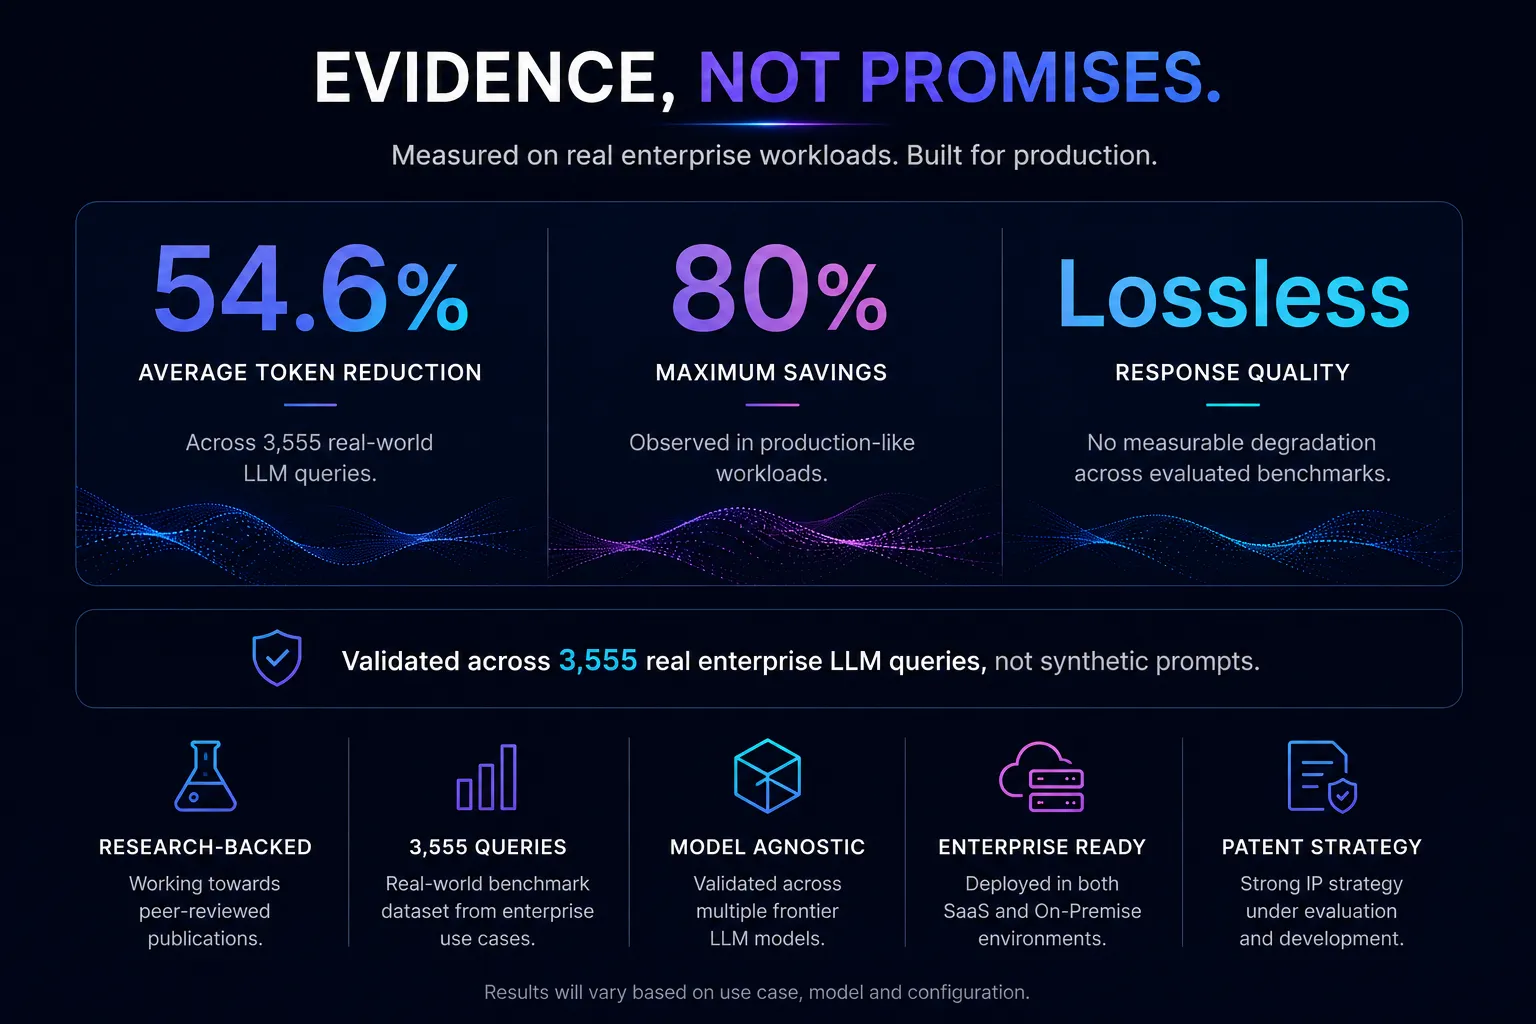
Nuestras pruebas en cargas de trabajo reales miden dos cosas a la vez: reducción de tokens y calidad de la salida. El objetivo no es comprimir prompts, sino determinar cuánta información se puede retirar sin afectar a la capacidad del modelo para resolver la tarea.
Reducción media de tokens, sobre 3.555 consultas LLM reales
Ahorro máximo observado en cargas de tipo producción
Sin degradación medible en los benchmarks evaluados
Validado sobre 3.555 consultas LLM reales de empresa, no prompts sintéticos.
Volumen de tokens procesados por el modelo en una carga de trabajo típica (−54,6%).
Una de las conclusiones clave de nuestra investigación es que la oportunidad de optimización crece a medida que los prompts se alargan. Es estratégicamente relevante: los sistemas de IA se mueven hacia contextos cada vez más grandes, así que RelAI gana valor según tus aplicaciones se vuelven más complejas.
Tendencia observada: a mayor longitud de contexto, mayor margen de optimización.
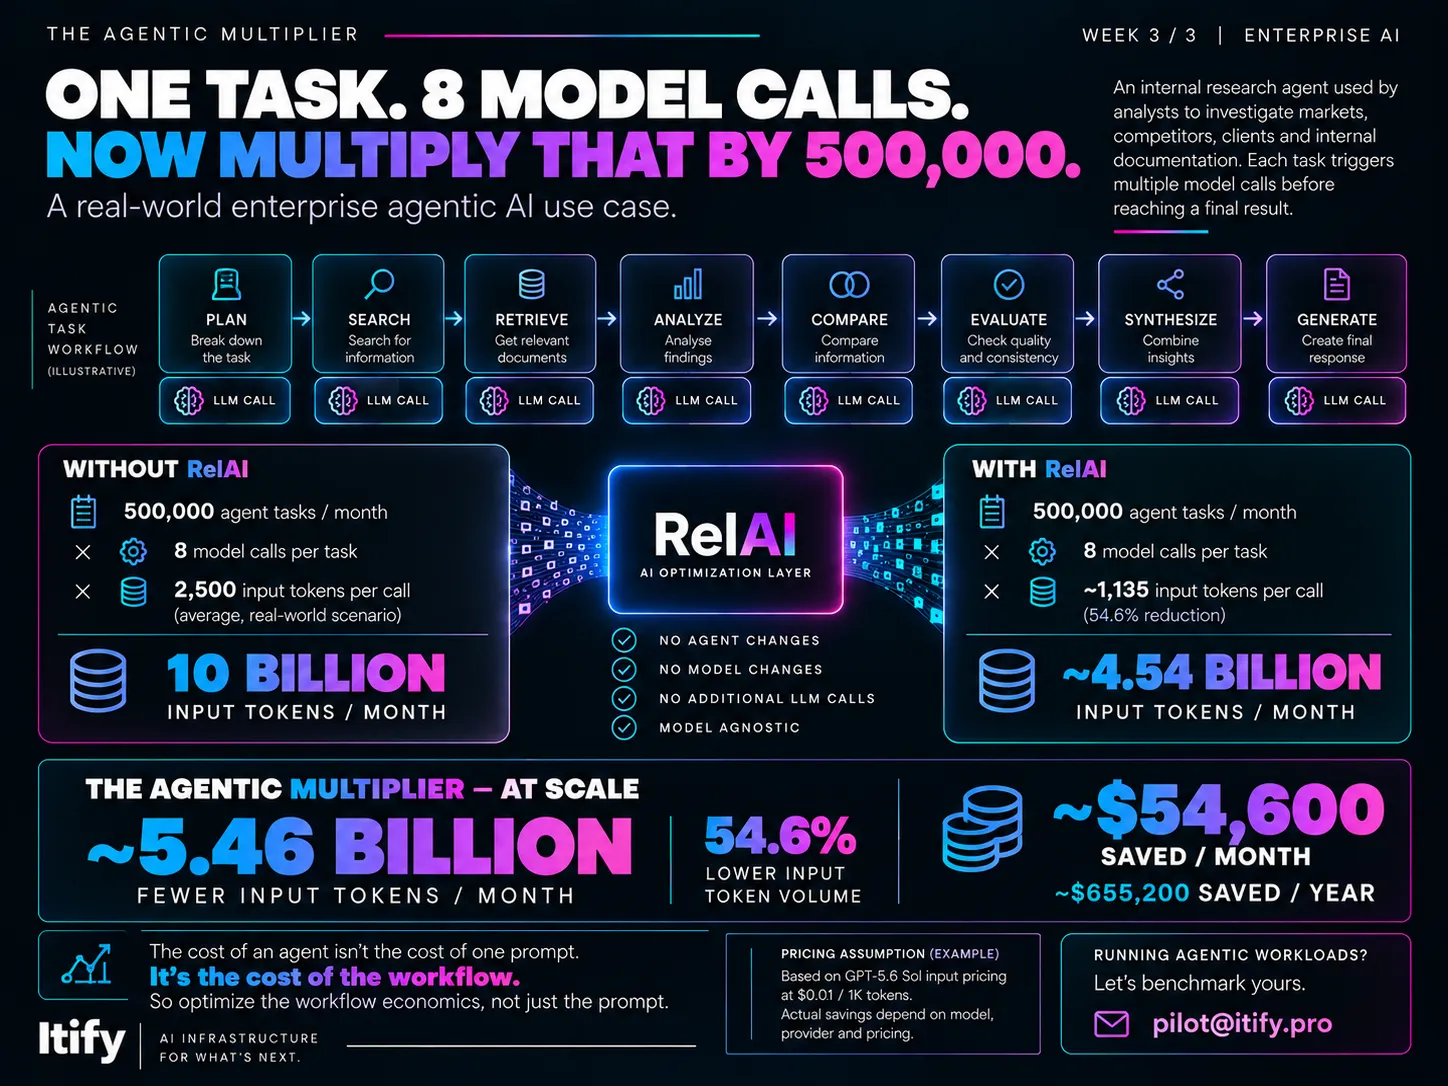
A pequeña escala, el ahorro por petición parece insignificante. Pero una tarea agéntica dispara varias llamadas al modelo, y eso se multiplica por millones de tareas al mes. Ahí el impacto económico es sustancial.
Caso ilustrativo: un agente de investigación interno ejecuta 8 llamadas al modelo por tarea, con 500.000 tareas al mes.
| Sin RelAI | Con RelAI | |
|---|---|---|
| Tareas de agente / mes | 500.000 | 500.000 |
| Llamadas al modelo / tarea | 8 | 8 |
| Tokens de entrada / llamada | 2.500 | ~1.135 (−54,6%) |
| Tokens de entrada / mes | 10.000 M | ~4.540 M |
Tokens de entrada menos / mes
Ahorro estimado / mes
Ahorro estimado / año
El coste de un agente no es el coste de un prompt: es el coste del flujo completo. Optimiza la economía del flujo, no solo el prompt.
Ejemplo con un precio de entrada de referencia ($0,01 / 1K tokens). El ahorro real depende del modelo, el proveedor y el precio.
Ajusta las variables a tu caso y estima el ahorro. RelAI es independiente del modelo: usa el precio de entrada del proveedor que prefieras.
Estimación orientativa. El ahorro real depende del tipo de carga de trabajo, el modelo y la configuración.
RelAI se valida con benchmarking sistemático sobre cargas reales y benchmarks consolidados. Medimos reducción de tokens y calidad de salida en paralelo, y presentamos los resultados con rigor estadístico.
Validado sobre 3.555 consultas LLM reales de empresa, no prompts sintéticos.
Razonamiento numérico · n=5 · media ± std
Sin diferencia estadísticamente significativa en calidad (test de McNemar, p > 0,05).
8.500 problemas de matemáticas que evalúan la capacidad de razonar con números.
Comprensión lectora · n=5 · media ± std
Sin diferencia estadísticamente significativa en calidad (test de McNemar, p > 0,05).
Dataset de comprensión lectora con preguntas sin respuesta.
Mantiene el rendimiento y la precisión del modelo.
Estadísticamente equivalente (test de McNemar, p > 0,05).
Menos tokens, menor coste, la misma inteligencia.
Menos energía, menos agua y menos emisiones de CO₂.
RelAI avanza hacia publicaciones revisadas por pares, con una estrategia de patentes en evaluación y desarrollo.
Haz tu infraestructura de IA más eficiente, controlable y segura. RelAI es independiente del modelo y del proveedor, y se despliega como SaaS o on-premise.
Menos tokens, menor coste de inferencia.
Gobierno de la IA consistente y centralizado.
Reduce el riesgo y mantén el dato en el contexto correcto.
Menos energía, menos agua y menos emisiones de CO₂.
Funciona con los LLM existentes, sin atarte a un modelo.
Tú decides qué proveedores usar. RelAI no pertenece a ninguno.
Cloud, infraestructura privada o tus propios servidores.
Pensada para operar IA a escala en entornos corporativos exigentes.
Visión
RelAI es el primer componente de una visión más amplia de Itify: infraestructura de IA para lo que viene.
A medida que la IA de empresa se vuelve más compleja, las organizaciones necesitarán una capa independiente entre sus aplicaciones y los modelos. La optimización es el primer problema que RelAI resuelve; el objetivo a largo plazo abarca eficiencia, gobernanza y operación de IA a escala.
Lo que compartimos sobre eficiencia de inferencia, economía de tokens e infraestructura de IA a escala.
Cuéntanos cómo usáis IA hoy. Te respondemos en menos de 48 horas con una primera lectura honesta del margen de optimización y de cómo encajaría RelAI en tu infraestructura.